AWS Glueとは?料金・機能・使い方を現役AWSエンジニアがわかりやすく解説

「S3にデータはたまっているのに、分析できる形に整えるのが大変…」「複数のシステムに散らばったデータを、いちいち手作業でつないでいる」。これらはデータ活用の現場でよく聞く悩みです。この地道で手間のかかる作業を肩代わりしてくれるのが、AWSのデータ統合サービスAWS Glue(グルー)です。
とはいえ、いざ調べ始めると「ETLって何?」「クローラーとかカタログとか用語が多い」「料金が高いって本当?」「LambdaやEMRと何が違うの?」と、入口で立ち止まりやすいサービスでもあります。
この記事では、AWS Glueとは何かという基礎から、主な機能、料金の目安、他サービスとの違い、始め方までを、専門用語をかみ砕きながら解説します。あわせて、「料金が想定より膨らむ落とし穴」「クローラーでのつまずき」など、公式ドキュメントだけでは気づきにくい実務でのポイントもまとめました。これからGlueを検討する方が、全体像と“使いどころ”をつかめる内容にしています。
監修:SHOGO
人材業界からキャリアチェンジし、ALHに入社。
開発からインフラまで、幅広い業務を担当。
2026 Japan All AWS Certifications Engineers。■保有資格
AWS Certified Cloud Practitioner / AWS Certified AI Practitioner / AWS Certified Solutions Architect - Associate / AWS Certified Developer - Associate / AWS Certified SysOps Administrator - Associate / AWS Certified Data Engineer - Associate / AWS Certified Machine Learning Engineer - Associate / AWS Certified Solutions Architect - Professional / AWS Certified DevOps Engineer - Professional / AWS Certified Security - Specialty / AWS Certified Advanced Networking - Specialty
運営元:ALH株式会社
ALH株式会社は、AWSパートナーネットワーク(APN)において、以下の認定を取得しているAWSパートナー企業です。◆ AWS 1000 APN Certification Distinction
AWS認定資格の取得数が1,000件を超えたパートナーに与えられる認定◆ AWS Training Partner
AWS公認の研修トレーニングを提供できるパートナー認定
◆ AWS Select Tier Services Partner
AWSサービスの構築・運用において一定の実績を持つパートナー認定
1. AWS Glueとは?サーバーレスのデータ統合(ETL)サービス
AWS Glueとは、データの抽出・変換・ロード(ETL)を、サーバーの管理なしで実行できるAWS公式のデータ統合サービスです。AWS公式は「あらゆる規模のデータを検出、準備、統合する、サーバーレスのデータ統合サービス」と説明しています(AWS Glue公式ページ)。
ポイントは大きく2つあります。ひとつはサーバーレスであること。処理に必要なマシンをGlueが自動で用意・拡張し、使い終わると解放するため、サーバーの構築・運用を意識せずに済みます。もうひとつは、バラバラの場所にあるデータを1か所に集めて分析できる形に整える役割を担うこと。AWS公式によれば、100を超える多様なデータソースに接続できます。
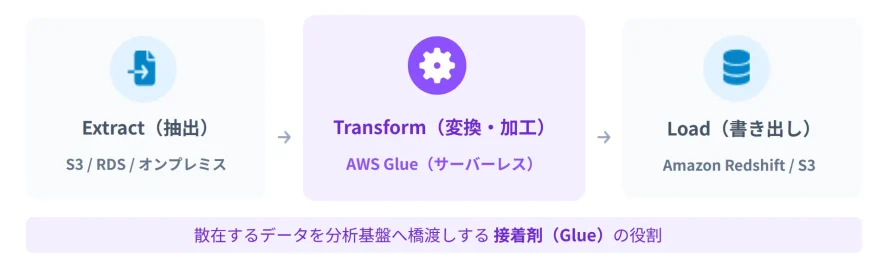
社内に散らばったデータ(売上、アクセスログ、顧客情報など)を分析基盤へ流し込む“のり付け”のような存在、とイメージすると分かりやすいです。
1-1. そもそもETLとは?(抽出・変換・書き出し)
ETLとは、「Extract(抽出)・Transform(変換)・Load(書き出し)」の頭文字をとった、データを分析できる形に整える一連の処理を指します。Glueを理解するうえで欠かせない前提なので、おさえておきましょう。
- Extract(抽出):データベースやログ、CSVファイルなど、あちこちにあるデータを取り出す
- Transform(変換):形式をそろえたり、不要なデータを取り除いたり、複数のデータを結合したりして、分析しやすい形に加工する
- Load(書き出し):加工したデータを、分析用の保存先(データレイクやデータウェアハウス)に書き込む
たとえば「店舗ごとにフォーマットの違う売上CSVを集めて、表記を統一し、分析用のS3にまとめる」といった作業が、まさにETLです。この流れをコードや画面操作で組み立て、自動で回せるようにするのがAWS Glueの中心的な役割になります。
▼データレイクの基盤となるAmazon S3についてはこちら
1-2. AWS Glueの「読み方」と名前の由来
AWS Glueの読み方は「グルー」です。「Glue」は英語で「接着剤・のり」を意味します。バラバラのデータやサービスを“のり付け”するようにつなぎ合わせて、ひとつの分析基盤にまとめる役割から名づけられたと考えると、サービスの特徴をとらえやすいです。
1-3. AWS Glueで何ができる?
ひと言でいえば「散らばったデータを集めて、分析できる形に整え、自動で回す」ことができます。次のような使い方が代表的です。
- 複数のデータソース(S3、RDS、オンプレDB、他クラウドなど)からデータを検出・準備・移動・統合する
- データの形式とスキーマを推論し、「どこに・どんな形式のデータがあるか」の目録(カタログ)を作る
- データの形式変換・クレンジング(不要データの除去や表記統一)を行う
- 加工したデータをデータレイクやデータウェアハウス(Amazon Redshiftなど)へロードする
- これらの処理をスケジュールやトリガーで自動実行する
「データはあるのに分析に使える状態になっていない」という課題を、コードの自動生成や画面操作の助けを借りながら解消していけるのがGlueの強みです。
2. AWS Glueの主な機能
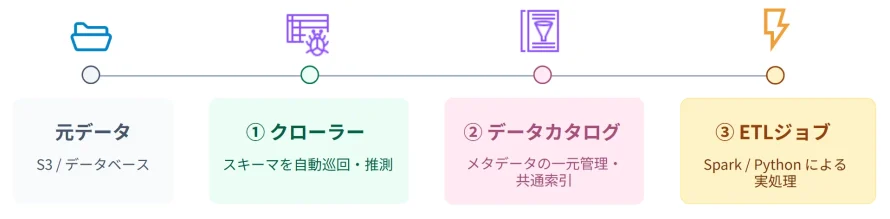
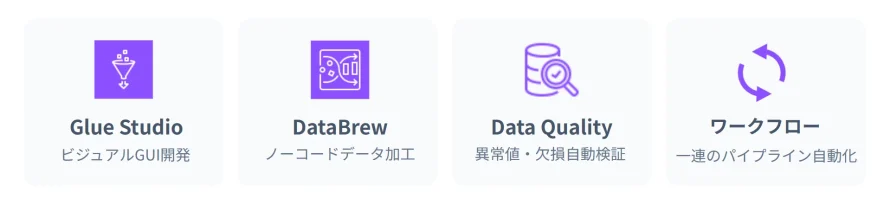
AWS Glueは複数の機能の集合体です。まず押さえるべきは「クローラー」「データカタログ」「ETLジョブ」の3つで、ここに画面操作系の「Glue Studio」「DataBrew」、品質チェックの「Data Quality」、自動化の「ワークフロー」が加わります。
| 機能 | ざっくり何をするか |
|---|---|
| クローラー | データソースを自動で読み取り、構造(スキーマ)をカタログに登録する |
| データカタログ | 「どこに・どんなデータがあるか」を記録した目録(メタデータの管理) |
| ETLジョブ | データの抽出・変換・ロードを実行する本体。Spark/Pythonで処理する |
| Glue Studio | ドラッグ&ドロップでETLを組めるビジュアル画面 |
| Glue DataBrew | コードを書かずにデータのクレンジング・加工ができるツール |
| Glue Data Quality | データの品質(欠損・重複・異常値など)を自動チェックする |
| ワークフロー | 複数のジョブやクローラーの実行順序を組んで自動化する |
2-1. クローラー(自動でスキーマを読み取る)
クローラーとは、データソースを自動で巡回して中身を調べ、その構造(スキーマ)をデータカタログに登録してくれる機能で、Webを巡回するクローラーと同じ発想です。
たとえばS3に置いたCSVやJSONファイルに対してクローラーを走らせると、「この列は日付型、この列は数値型」といった構造を自動で推測し、カタログにテーブルとして登録します。手作業でスキーマを定義する手間を省けるのが大きな利点です。ただし、ファイルの形式や置き方によっては意図しない形で推測されることもあり、ここは後述のつまずきポイントでも触れます。
2-2. データカタログ(データの目録)
データカタログとは、「どこに、どんな形式のデータがあるか」を記録しておく“目録”のことです。データそのものではなく、データの説明情報(メタデータ)を管理します。テーブル名、列名、データ型、保存場所などが登録され、これを見れば実データを開かなくても中身の見当がつきます。
このカタログは、後述するAmazon Athena(S3のデータにSQLを投げるサービス)やAmazon Redshiftなど、他の分析サービスからも共通で参照できます。「分析基盤の共通の索引」として機能する、Glueの土台となる仕組みです。
2-3. ETLジョブ(データを変換する本体)
ETLジョブとは、実際にデータの抽出・変換・ロードを実行する処理本体です。Glueの“エンジン”にあたる部分で、主にApache Spark(大規模データを高速に分散処理するフレームワーク)や、軽量な処理向けのPython Shellで動きます。
大きなメリットは、変換内容を指定すると処理コードがある程度自動生成される点です。さらに近年は生成AIによる支援機能も組み込まれ、AWS公式はETLの作成やSparkのトラブルシューティングを支援すると説明しています。もちろん自分でPythonコードを書き込んで、細かい変換ロジックを実装することもできます。
2-4. Glue Studio(画面で作るビジュアルETL)
Glue Studioとは、ETLの処理をドラッグ&ドロップの画面操作で組み立てられるビジュアルツールです。「データを読み込む→列を絞る→結合する→書き出す」といった流れを、ブロックをつないでいく感覚で設計できます。
裏側では対応するコードが生成されるため、コードにあまり慣れていない人でも処理の流れを組み立てやすく、慣れた人は生成されたコードを微調整して使えます。「まず画面で骨組みを作り、細部はコードで詰める」といった進め方ができるのが便利な点です。
2-5. Glue DataBrew(コード不要のデータ加工)
Glue DataBrewとは、コードを一切書かずに、表計算ソフトのような感覚でデータのクレンジング・加工ができるツールです。欠損値の補完、表記ゆれの統一、列の分割・結合などを、用意された変換メニューから選んで適用していきます。
エンジニアでなくてもデータ加工に取り組みやすいのが特徴で、データ分析の担当者やアナリストが前処理を自分で進めたい場面にも向きます。なお、DataBrewはGlue本体のジョブとは料金体系が異なる点には注意が必要です(後述)。
2-6. Glue Data Quality(データ品質チェック)
Glue Data Qualityとは、データの品質(欠損・重複・想定外の値など)を自動でチェックする機能です。「この列は空であってはならない」「値は0〜100の範囲に収まるはず」といったルールを定義し、データがそれを満たしているかを検証します。
分析や機械学習は“入力データの質”に結果が大きく左右されることから、品質の悪いデータが下流に流れ込むのを防ぐ関所として、パイプラインに組み込む価値のある機能です。
2-7. ワークフロー(処理の流れを自動化)
ワークフローとは、複数のクローラーやジョブの実行順序を組み立てて、一連の処理として自動化する機能です。「クローラーでカタログを更新→ETLジョブで変換→次のジョブでロード」といった流れを、トリガー(きっかけ)でつないで自動実行できます。
スケジュール実行(毎朝5時に回すなど)や、前の処理の完了を合図に次を動かすといった制御ができるため、定型的なデータ処理を人手を介さず回すことが可能になります。
3. AWS Glueの料金|「高い」と言われる理由と目安
AWS Glueの料金は、処理に使った計算リソースの量(DPU時間)に応じた従量課金が基本です。AWS Glueは料金高めのイメージが持たれがちですが、多くの場合、“使った分だけ課金される”仕組みへの理解と、こまめな設定でかなりコントロールができます。ここでは基本の考え方と目安を整理します。
3-1. 料金の基本(DPUという単位)
Glueの計算料金は「DPU(Data Processing Unit)」という単位で測ります。DPUは処理能力の単位(1 DPU=4 vCPU・16GBメモリ相当)で、「使ったDPUの量 × 動いた時間」で料金が決まります。サーバーを立てて放置しても課金され続けるタイプではなく、ジョブが動いている間だけ課金されるイメージです。
「高い」と感じるケースの多くは、必要以上に大きなリソースを割り当てていたり、ジョブが長時間動いていたり、DataBrewやクローラーなど複数機能の料金が積み上がっていたりするパターンです。どの機能にいくらかかるかを把握すれば、過剰なコストは避けられます。
なお、2026年8月にリリースされたGlue 6.0では、DPU時間あたりの単価が30%引き下げられました。課金の仕組み自体は変わっていないため、既存のジョブをGlue 6.0へ移行するだけで単価が下がります。「高い」と感じていた方は、まず使用中のGlueバージョンを確認してみてください。
3-2. 主な料金一覧(表)
代表的な料金は次のとおりです(いずれもUSD表記で、リージョンやバージョンにより異なる場合があります)。
※本セクションの料金情報は2026年9月時点のAWS公式ページを参考にしています。リージョンはアジアパシフィック(東京)にて確認しています。料金は予告なく変更される場合があります。利用前には必ずAWS公式料金ページで最新情報をご確認ください。(出典:AWS Glue料金ページ)
| 項目 | 料金の目安 | 補足 |
|---|---|---|
| ETLジョブ(Apache Spark) | 0.44 USD/DPU時間 | 1秒単位で課金され、1分間分(Glue バージョン 2.0 以降)または10分間分(Glue バージョン 0.9/1.0)の最低料金がかかります |
| クローラー | 0.44 USD/DPU時間 | 秒単位課金・最小10分から(ETLジョブの最小1分と異なる点に注意) |
| Flex実行(フレキシブル実行クラス)のApache Spark | 0.29 USD/DPU時間 | 1秒単位で課金され、1分間分の最低料金がかかります(Glue バージョン 3.0 以降) |
| データカタログ(保存) | 最初の100万オブジェクトまで無料 | 超過分は10万オブジェクトごとに1.00 USD/月 |
| データカタログ(リクエスト) | 毎月100万リクエストまで無料 | 超過分は100 万件のリクエストごとに1.00 USD/月 |
| Glue DataBrew(インタラクティブセッション) | 1.00 USD/セッション | 使用したセッションの総数で課金され、30分単位で計算されます。初回利用者は最初の40セッション無料 |
| Glue DataBrew(ジョブ) | 0.48 USD/ノード時間 | AWS Glue DataBrew のジョブが他の AWS サービスを使用する、またはデータを転送すると、追加料金が発生する場合があります |
なお、データカタログの「オブジェクト」にはテーブルだけでなく、テーブルのバージョン、パーティション、パーティションインデックス、統計情報、データベースなどがすべて個別に数えられます。日付や地域などの条件で細かくパーティションを分割する構成ではオブジェクト数が想定より早く増えるため、テーブル数が少なくても100万を超えることがあります。
小規模なデータ整備であれば、データカタログの無料枠内で収まり、実質的な課金はジョブの実行時間分だけというケースも珍しくありません。
3-3. 料金を抑えるコツ(Flex実行など)
現役エンジニアの視点で、コストを抑える実務的なポイントを挙げます。
- Glueバージョンを見直す:Glue 6.0以降は、5.1以前よりDPU時間あたりの料金が30%安くなっています。移行できる環境であれば有力な選択肢です。ただし、どれだけ削減できるかはジョブの内容次第で、DPU数の最適化など別の見直しのほうが効果が大きいケースもあります
- 急ぎでない処理はFlex実行を検討する:夜間バッチなど「多少開始が遅れても困らない」ジョブ向けに、空きリソースで実行する代わりに単価を抑えた「Flex実行」という実行クラスがあります(Glue 3.0以降のSparkジョブで利用可能)。Glue 5.1以前では通常0.44 USD/DPU時間のところ0.29 USD/DPU時間になり、約34%安くなります。システムの対応状況などでGlue 6.0へすぐに移行できない場合でも、今のバージョンのままFlex実行に切り替えればコストを抑えられます(Glue 6.0でFlex実行を使った場合の単価は、公式料金ページでご確認ください)。
- DPU数を盛りすぎない:DPUを増やしても、処理速度がそれに比例して上がるとは限らず、処理の並列化を見直したほうが速くなるケースもあります。一方で、DPUを増やせばその分時間あたりの料金は上がります。データ量に見合ったサイズから始めるのが基本です
- 不要なクローラーを走らせっぱなしにしない:クローラーは1回の実行につき最低10分が課金されます。数秒で終わる小さなデータでも10分の課金がされるため、頻繁なスケジュール実行はコストに直結します。必要なときだけ実行する設定に見直しましょう
- DataBrewやData Qualityなど追加機能の料金を把握する:本体ジョブとは別に積み上がるため、使う機能を絞りましょう
- Auto Scalingでワーカー数を自動調整する:Glue 3.0以降では、処理の負荷に応じてワーカー数を自動で増減させるAuto Scalingを使えます。最大ワーカー数を上限として決めておけば、使われていないワーカーは自動で削除されるため、リソースの割り当て過多を抑えられます
- ジョブブックマークで処理済みデータの再処理を防ぐ:定期実行するジョブでは、ジョブのブックマークを有効にすると、前回の実行以降に追加されたデータだけを処理できます。毎回すべてのデータを読み直さずに済むため、処理時間の短縮につながります
- プッシュダウンで読み込むデータを絞る:プッシュダウンは、絞り込み条件や列の選択をデータソース側で先に適用し、必要なデータだけをGlueに読み込む最適化の手法です。たとえばS3のデータを日付でパーティション分割しておけば、必要な期間のパーティションだけを読み込めます
- ジョブにタイムアウトを設定する:ジョブは実行時間に応じて課金されるため、処理が想定外に長引くとそのまま料金がかさみます。ジョブのタイムアウトを想定実行時間に合わせて分単位で設定しておきましょう。未設定の場合のデフォルトは、Glue 5.0以降で480分(8時間)、4.0以前で2,880分(48時間)です
「使った分だけ」という仕組みは、裏を返せば設定次第でコストが動くということです。小さく始めて料金を確認する運用が、想定外の請求を防ぐいちばんの近道になります。
4. AWS Glueと他サービスの違い(Lambda/EMR/Athena)
Glueは「データ統合・ETLに特化したマネージドサービス」で、他サービスとは役割が異なります。導入時によく比較されるLambda・EMR・Athenaとの違いを一覧で整理しました。
| サービス | 主な役割 | Glueとの違い・使い分け |
|---|---|---|
| AWS Glue | サーバーレスのETL/データ統合 | データの変換・統合を、基盤管理なしで自動化する |
| AWS Lambda | 短時間の処理を動かす汎用の実行環境 | 軽量・短時間の処理向け。大規模データのETLには不向き |
| Amazon EMR | Hadoop/Sparkクラスターの実行基盤 | クラスターを自分で管理。大規模・細かい制御が必要な処理向け |
| Amazon Athena | S3のデータにSQLで問い合わせる分析サービス | データを「整える」のがGlue、「問い合わせる」のがAthena |
4-1. AWS Lambdaとの違い
Lambdaは「短い処理を手軽に動かす汎用サービス」、Glueは「大規模データのETLに特化したサービス」です。Lambdaでも簡単なデータ加工はできますが、実行時間に上限があり、大量データを分散処理する用途には向きません。「軽い変換や、イベントをきっかけにした小さな処理」ならLambda、「まとまった量のデータをまとめて変換・統合」ならGlue、という使い分けが基本です。
▼Lambdaについてはこちら
4-2. Amazon EMRとの違い
EMRは「SparkやHadoopのクラスターを自分で管理して動かす基盤」、Glueは「その管理をAWSに任せられるサーバーレス版」というイメージです。EMRはクラスターの構成やチューニングを細かく制御できる反面、運用の手間がかかります。Glueは自由度では劣るものの、基盤管理を意識せずETLを回せる手軽さが魅力です。「細かい制御・特殊な構成が必要ならEMR」「まず手早くETLを組みたいならGlue」と考えると選びやすくなります。
4-3. Amazon Athenaとの違い
Athenaは「S3のデータにSQLで問い合わせて分析するサービス」で、Glueとは役割が補完関係にあります。データを分析できる形に整えるのがGlue、整ったデータに問い合わせて答えを得るのがAthenaです。しかもAthenaはGlueのデータカタログを参照して動くため、両者はセットで使われることが多くあります。「Glueでカタログを整備し、Athenaでクエリを投げる」という組み合わせは、S3を中心としたデータ分析の定番構成です。
5. AWS Glueのメリット・デメリット
導入を判断するうえで、メリットとデメリット両方を現役エンジニア視点で整理しました。
5-1. メリット
- サーバー管理が不要:サーバーレスなので、基盤の構築・運用・スケーリングをAWSに任せられる
- データ分析基盤を素早く構築できる:クローラーやコード自動生成の助けで、ゼロから組むより早く立ち上がる
- 使った分だけの従量課金:常時サーバーを持つ必要がなく、処理が動いた分だけの支払いで済む
- AWSの他サービスと連携しやすい:S3・Athena・Redshiftなどと組み合わせて、分析基盤を一体で作れる
- 自動化しやすい:スケジュールやトリガーで、定型のデータ処理を人手なしで回せる
- データを一元管理しやすい:データカタログにメタデータを集約することで、複数のデータソースにまたがるデータを1か所で検索・管理でき、AthenaやRedshift Spectrumなどからもそのまま参照できる(参考:AWS公式ドキュメント)
5-2. デメリット
- 設定次第でコストが読みにくい:DPUの割り当てやジョブ時間、追加機能の積み上がりで、想定より高くなることがある
- 学習コストがある:カタログ・クローラー・ジョブなど概念が多く、Sparkの知識があると理解が早い
- バージョンアップ時に互換性の確認が必要:新しいGlueバージョンでは中で動くSparkやPythonも更新されるため、既存ジョブを移行する際にコードや設定の修正が必要になることがある(詳しくは「6-2. Glueのバージョンはどれを選ぶ?」で解説)
- オンプレミス環境との連携には準備がいる:社内システムとつなぐ場合、ネットワークや接続設定に一手間かかる
- リアルタイム処理が主目的なら別の選択肢も:Glueはバッチ処理が得意で、ミリ秒単位の即時処理が中心なら他サービスの検討も必要
「サーバーレスで手軽」な反面、最初はコスト管理と概念の理解にハードルがあると言えます。小さく試しながら必要なポイントをおさえていくのがおすすめです。
6. AWS Glueの始め方(基本の流れ)
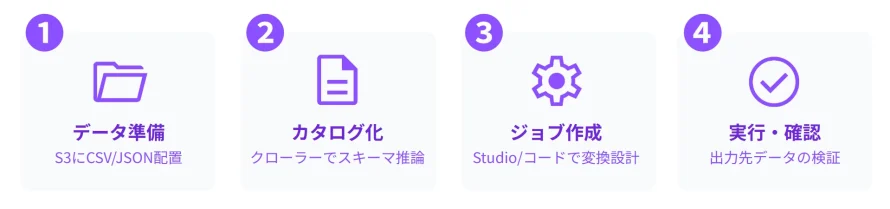
Glueを使い始める流れは、「データを置く→クローラーでカタログ化→ジョブで変換→結果を確認」の4ステップが基本です。細かい画面操作は変わることがあるため、ここでは全体の流れをお伝えします。
6-1. 使い始める4ステップ
- データソースを用意する:まずは変換したいデータ(S3上のCSVやJSONなど)を用意する
- クローラーを作成・実行する:データソースを指定してクローラーを走らせ、データカタログにテーブルを作る
- ETLジョブを作成する:Glue Studioの画面、またはコードで「読み込む→変換する→書き出す」処理を組む
- ジョブを実行して結果を確認する:ジョブを動かし、出力先(S3やRedshiftなど)に狙いどおりのデータができているかを確認する
最初は小さなサンプルデータで一連の流れを通してみると、各機能の役割が体感で理解できます。AWSは公式のチュートリアルやハンズオン資料も用意しているので、それに沿って進めるのが安全です。
6-2. Glueのバージョンはどれを選ぶ?
ジョブを作る際は「Glueバージョン」を選びますが、これは中で動くApache SparkとPythonのバージョンを決めるものです。特にこだわりがなければ、新しいバージョンを選ぶのが基本です。
AWS公式のリリースノートによれば、Glueのバージョンは世代ごとに対応するSpark/Pythonが異なります(AWS Glueバージョン(公式ドキュメント)より)。
| Glueバージョン | Apache Spark | Python |
|---|---|---|
| Glue 6.0 | Spark 4.1.1 | Python 3.13 |
| Glue 5.1 | Spark 3.5.6 | Python 3.11 |
| Glue 5.0 | Spark 3.5.4 | Python 3.11 |
| Glue 4.0 | Spark 3.3.0 | Python 3.10 |
| Glue 3.0 | Spark 3.1.1 | Python 3.7 |
最新のGlue 6.0では、Spark 4.1.1への更新に加えてApache Iceberg V3(バリアントデータ型、削除ベクトル、行リネージュなど)に対応し、さらに料金が30%引き下げられました。新規に作るジョブは6.0を選ぶのが基本になります。
ただしSpark 4系・Python 3.13への大きな更新を含むため、既存ジョブの移行時は互換性の確認が必要です。具体的な変更点はAWS公式の移行ガイドにまとまっています。また、Glue Studioには、非互換箇所を検出して修正案を提示する生成AIのアップグレード支援機能も用意されています(AWS公式ドキュメント)。
なお、古いGlue 0.9/1.0/2.0は、AWS公式のバージョンサポートポリシーにより2026年4月1日にサポート終了(EOL)となっています。既存のジョブで古いバージョンを使っている場合は、新しいバージョンへの移行を進めておきましょう。バージョンは進化が速いため、最新の対応状況は必ず公式ドキュメントでご確認ください。
7. 現役エンジニアがつまずいたポイントと対処
ここでは、実際に手を動かしたときにつまずきがちなパターンと対処法をまとめます。公式ドキュメントだけでは気づきにくい、実務ならではのポイントです。
| つまずき | よくある原因 | 対処 |
|---|---|---|
| クローラーがスキーマを意図と違う形で認識 | ファイル形式・区切り・混在データの推測ミス | 出力を確認し、必要なら分類子やスキーマを調整する。再実行によるスキーマの上書きにも注意する |
| 料金が想定より高い | DPUの割り当て過多・ジョブの長時間化 | Glueバージョン(6.0で単価30%減)やDPU数を見直し、必要ならFlex実行やAuto Scalingも検討 |
| ジョブが権限エラーで失敗 | IAMロール(実行権限)の設定不足 | ジョブ用ロールにS3など必要なアクセス権を付与する |
| S3の大量の小さいファイルで遅い・割高 | 小ファイルが多く処理効率が落ちる | ファイルを適切なサイズにまとめる/Glueのファイルグループ化機能を活用する |
| DataBrewやクローラーの料金が積み上がる | 本体ジョブ以外の料金を見落とし | 使う機能を絞り、不要なスケジュール実行を止める |
いきなり本番の大量データで走らせない
Glueは大規模データを扱えるぶん、設定を誤ったまま本番データで走らせると、時間もコストも一気にかさみます。慣れるまでは、まず少量のサンプルデータで一連の流れを確認し、狙いどおりに動くと分かってから本番データに広げるのが安全です。
クローラーの結果は必ず目視する
クローラーは便利ですが、自動推測が常に正解とは限りません。列の型が想定と違ったり、意図しないテーブル分割が起きたりすることがあります。カタログに登録された結果を一度は目で確認し、変換の前提がずれていないかをチェックするクセをつけると、下流での手戻りを防げます。
8. AWS Glueに関するよくある質問(FAQ)
Q1. AWS Glueの読み方は?
「グルー」と読みます。英語の「glue(接着剤・のり)」が由来で、バラバラのデータをつなぎ合わせる役割から名づけられたと考えると、サービスの特徴をとらえやすいです。
Q2. AWS Glueは無料で使えますか?
Glueというサービス自体に固定の基本料金はなく、使った分だけの従量課金です。データカタログには無料枠(保存100万オブジェクト・月100万リクエストまで)があり、小規模な用途なら実質的な課金がジョブの実行時間分だけで収まることもあります。ただしジョブやクローラーを実行すれば料金が発生します。
Q3. プログラミングができなくても使えますか?
ある程度は可能です。画面操作でETLを組めるGlue Studioや、コード不要でデータ加工ができるGlue DataBrewを使えば、コードをほとんど書かずに扱えます。ただし複雑な変換や細かい制御を行う場合は、PythonやSparkの知識があるとスムーズです。
Q4. AWS GlueとAmazon Athenaはどう違いますか?
データを分析できる形に「整える」のがGlue、整ったデータに「問い合わせて答えを得る」のがAthenaです。AthenaはGlueのデータカタログを参照して動くため、両者はセットで使われることが多く、対立するサービスではありません。
Q5. オンプレミス(社内)のデータベースとも連携できますか?
連携できます。ただし、社内システムとつなぐ場合はネットワークや接続設定の準備が必要で、S3同士のような手軽さとはいきません。接続方式やセキュリティ設計を含めて計画的に進めるのがおすすめです。
まとめ
AWS Glueは、散らばったデータを集めて分析できる形に整え、その処理を自動で回すためのサーバーレスなデータ統合サービスです。この記事のポイントを振り返ります。
- AWS Glueとは:ETL(抽出・変換・ロード)をサーバー管理なしで実行できるデータ統合サービス。読み方は「グルー」
- 主な機能:土台となる「データカタログ」「クローラー」「ETLジョブ」を中心に、Studio・DataBrew・Data Quality・ワークフローが揃う
- 料金:DPU時間あたりの従量課金が基本で、Glue 6.0以降は30%OFFの低価格。無料枠やバージョンの選択で、コストは設定でコントロールできる
- 他サービスとの違い:整えるのがGlue、問い合わせるのがAthena、大規模・細かい制御はEMR、軽量処理はLambda
- 始め方:「データを置く→クローラー→ジョブ→結果確認」の4ステップ。まずは小さなデータで流れをつかむ
「データはあるのに活用しきれていない」という悩みは、多くの現場に共通します。Glueはその第一歩を、基盤構築の重さを肩代わりしながら支えてくれるサービスです。まずは少量のデータでクローラーとジョブを一度通してみるところから、始めてみてください。
参考リンク
- AWS Glue公式ページ(AWS)
- AWS Glue料金ページ(AWS)
- AWS Glueバージョン(AWS)
- AWS Glue 6.0の一般提供・30%値下げ告知(AWS公式ブログ)
- Glue 6.0への移行ガイド(AWS公式ドキュメント)
- 生成AIによるSparkアップグレード(AWS公式ドキュメント)
- AWS Glueとは(AWS公式ドキュメント)
- Auto Scaling(AWS公式ドキュメント)
- ジョブのブックマーク(AWS公式ドキュメント)
- プッシュダウンによる読み取りの最適化(AWS公式ドキュメント)
- ジョブのプロパティ・タイムアウト(AWS公式ドキュメント)
いずれも2026年9月時点(AWS公式ドキュメントの追加分は2026年11月時点)の情報です。料金・対応バージョン・機能は改定される場合があります。最新の内容は各公式ページでご確認ください。
関連記事


この記事を書いた人